理化学研究所・特別研究員の鹿俣尚志氏とチームディレクターの後藤隼人氏の研究チームは、量子コンピューターで計算に使う論理量子ビットを、少ないリソースで誤りから守る符号化法を開発した(ニュースリリース)。数値シミュレーションでは、従来手法と同程度の低い論理CNOTゲートの誤り率を維持しながら、必要な物理量子ビットの平均総数を半分以下に削減できることを確認した。
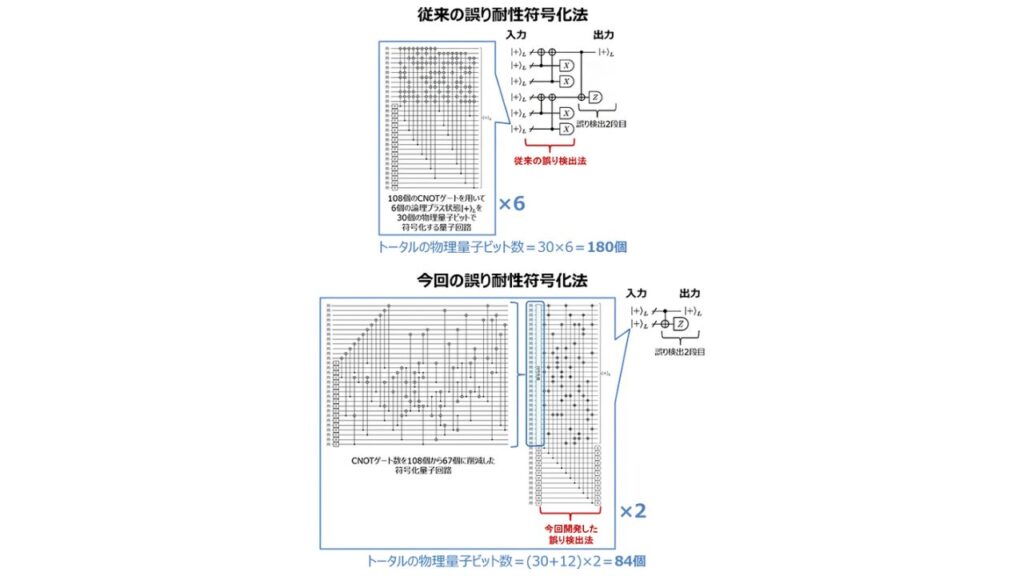
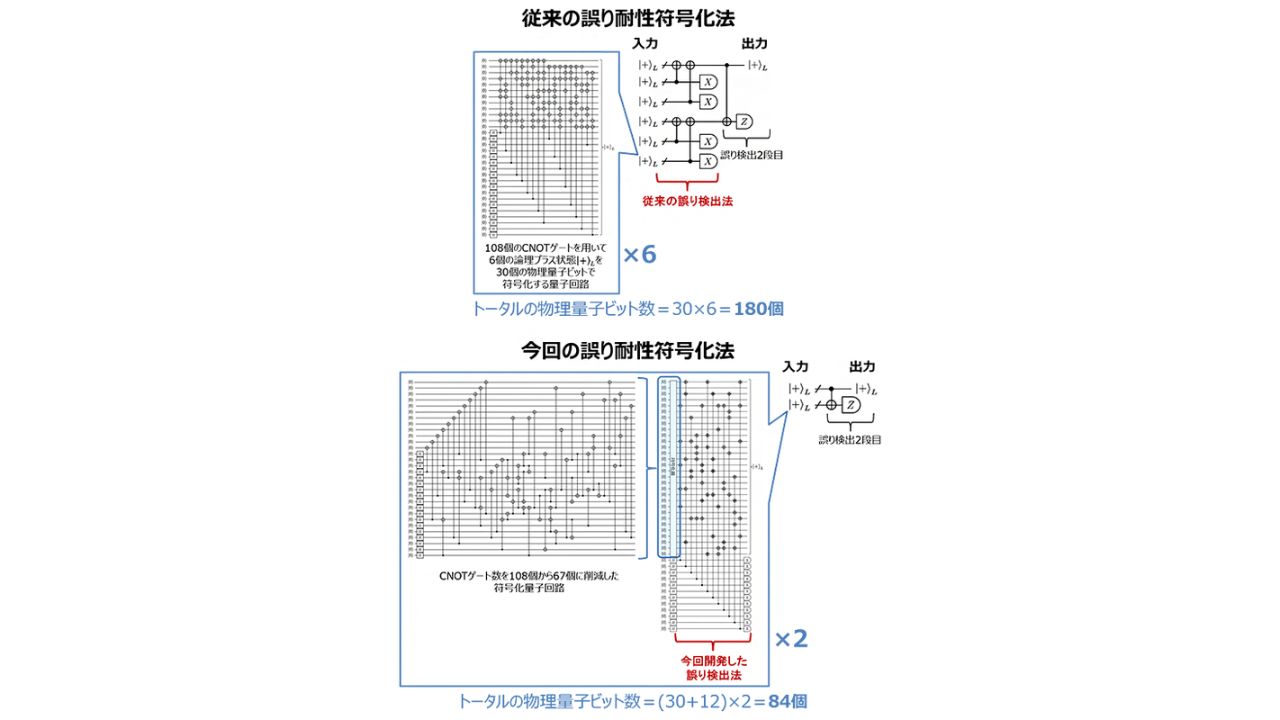
従来手法と提案手法による誤り耐性符号化法の比較
量子コンピューターは、量子もつれなど量子力学に特有の状態を利用して計算するが、周囲の環境や操作の不完全さによって誤りが生じる。このため、量子情報を複数の量子ビットに分散して記録し、誤りを検出・訂正する仕組みが必要となる。装置上の個々の量子ビットを「物理量子ビット」、複数の物理量子ビットを使い、量子誤り訂正によって保護された量子ビットを「論理量子ビット」と呼ぶ。
有力な誤り訂正方式の一つである「表面符号」は、物理量子ビットを平面上に配置しやすい一方、論理量子ビット一つを守るために多数の物理量子ビットを必要とする。複数の論理量子ビットをまとめて符号化する「高レート量子符号」は、必要な物理量子ビット数を抑えられる可能性がある。ただし、実際の量子計算への適用には、多数の補助的な物理量子ビットや複雑な誤り検出回路が必要となり、省リソース性が損なわれる課題があった。
研究チームは、高レート量子符号の一種である「シンプレクティック・ダブル符号」を対象に、符号化回路と、符号化中に生じる誤りを検出する方法を見直した。
具体的には、6個の論理量子ビットをプラス状態に準備する符号化回路で、基本量子ゲート「CNOT」の数を108個から67個に削減した。さらに、1個の論理量子ビットを7個の物理量子ビットで符号化する「スティーン符号」向けに開発された誤り検出法を、シンプレクティック・ダブル符号に拡張した。これにより、従来の誤り検出法と比べ、少ない物理量子ビットで致命的な誤りを検出できるようにした。
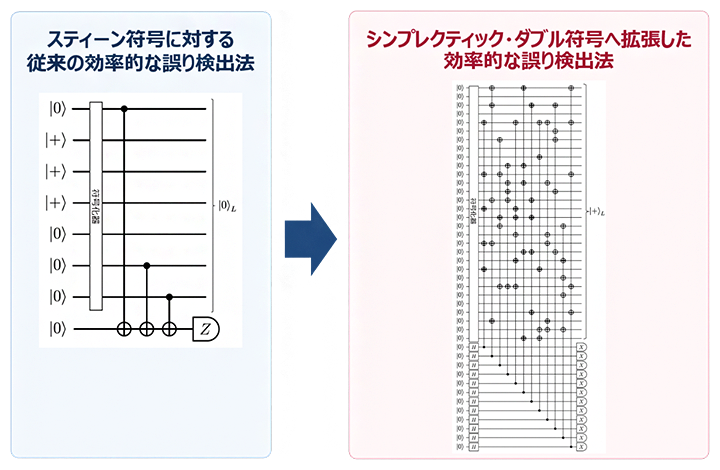
図1 スティーン符号の効率的な誤り検出法を「シンプレクティック・ダブル符号」へ拡張
今回用いた符号は、30個の物理量子ビットで6個の論理量子ビットを保護する。物理量子ビット数に対する論理量子ビット数の割合を表す「符号化率」は20%で、同程度の誤り訂正能力を持つ表面符号の4%を上回る。数値シミュレーションでは、論理量子ビットに対するCNOTゲートの誤り率と、6個の論理量子ビットをプラス状態に準備するために必要な物理量子ビットの平均総数を評価した。その結果、従来手法と同程度の低い誤り率を維持しながら、物理量子ビット数を半分以下に削減できることを確認した。研究チームはさらに、6個の論理量子ビットを任意の状態に準備する方法も考案した。
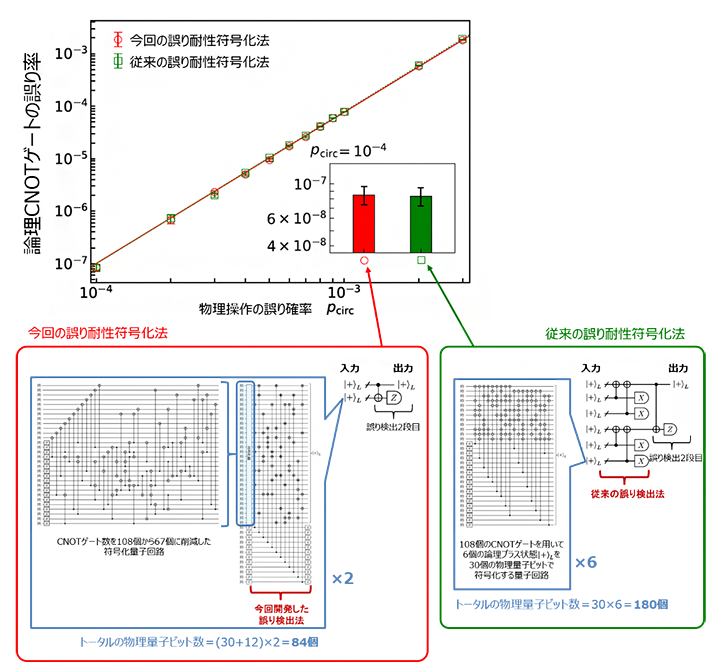
図2 従来と今回の誤り耐性符号化法の性能比較
今後、実機に適用できれば、搭載できる物理量子ビット数が限られる装置でも、より多くの論理量子ビットを効率的に利用できる可能性がある。誤りを抑えながら大規模な量子計算を実行するための基盤技術として期待される。